
TÓM TẮT
- 1 Mở Đầu
- 2 1. Tổng Quan Về Cây Quyết Định
- 3 2. Các Thuật Toán Xây Dựng Cây Quyết Định
- 4 3. Các Bước Cơ Bản Để Vẽ Cây Quyết Định
- 5 4. Thực Hành: Vẽ Cây Quyết Định Bằng Python
- 6 5. Kỹ Thuật Nâng Cao Để Tối Ưu Cây Quyết Định
- 7 6. Ứng Dụng Thực Tế Của Cây Quyết Định
- 8 7. Những Sai Lầm Thường Gặp Khi Vẽ Cây Quyết Định
- 9 8. Kết Luận
Mở Đầu
Trong thời đại dữ liệu ngày càng phong phú, việc đưa ra quyết định nhanh chóng và chính xác là yếu tố then chốt giúp các doanh nghiệp và nhà nghiên cứu đạt được lợi thế cạnh tranh. Cây quyết định (Decision Tree) là một trong những mô hình học máy đơn giản, dễ hiểu và mạnh mẽ, được áp dụng rộng rãi trong các lĩnh vực như tài chính, y tế, marketing, và quản lý rủi ro. Bài viết này sẽ cung cấp cho bạn một hướng dẫn chi tiết, từ những kiến thức cơ bản nhất đến các kỹ thuật nâng cao, nhằm giúp bạn vẽ cây quyết định một cách hiệu quả và tối ưu.
1. Tổng Quan Về Cây Quyết Định
1.1 Định Nghĩa
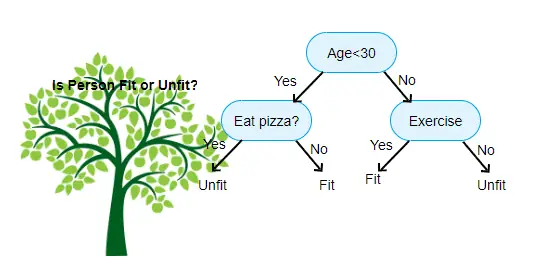
Cây quyết định là một cấu trúc dạng cây, trong đó mỗi nút nội bộ (internal node) đại diện cho một điều kiện kiểm tra (feature test), mỗi nhánh (branch) đại diện cho kết quả của điều kiện, và mỗi nút lá (leaf node) đại diện cho kết quả dự đoán (class label hoặc giá trị liên tục).
1.2 Ưu Điểm

Có thể bạn quan tâm: Cách Vẽ Cây Dừa Đẹp: Hướng Dẫn Từng Bước Cho Người Mới Bắt Đầu Và Người Thành Thạo
| Ưu điểm | Mô tả |
|---|---|
| Dễ hiểu | Cấu trúc cây trực quan, người không chuyên cũng có thể đọc được. |
| Không yêu cầu chuẩn hoá dữ liệu | Không cần chuẩn hoá hoặc chuẩn hoá tính năng. |
| Xử lý dữ liệu hỗn hợp | Có thể làm việc với dữ liệu số và danh mục cùng lúc. |
| Tự động lựa chọn tính năng | Thuật toán tự động chọn các tính năng quan trọng nhất. |
| Khả năng mở rộng | Dễ dàng mở rộng sang các mô hình ensemble như Random Forest, Gradient Boosting. |
1.3 Nhược Điểm
- Dễ bị overfitting khi cây quá sâu.
- Không ổn định với đổi biến nhỏ trong dữ liệu.
- Không thể mô hình hoá các mối quan hệ phi tuyến phức tạp nếu không có đủ độ sâu.
2. Các Thuật Toán Xây Dựng Cây Quyết Định
2.1 ID3 (Iterative Dichotomiser 3)
- Tiêu chí chia: Thông tin lợi nhuận (Information Gain) dựa trên entropy.
- Ưu điểm: Đơn giản, nhanh chóng.
- Nhược điểm: Ưu tiên các thuộc tính có nhiều giá trị, dễ overfit.
2.2 C4.5
- Tiêu chí chia: Gain Ratio (Information Gain được chuẩn hoá).
- Khả năng: Xử lý dữ liệu mất giá trị, cắt tỉa (pruning) sau khi xây dựng.
- Ưu điểm: Cải thiện ID3, giảm bias.
2.3 CART (Classification and Regression Trees)
Có thể bạn quan tâm: Cách Vẽ Cánh Ác Quỷ: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
- Tiêu chí chia: Gini impurity cho bài toán phân loại, MSE cho hồi quy.
- Cây nhị phân: Mỗi nút chỉ có 2 nhánh (true/false).
- Cắt tỉa: Sử dụng cost-complexity pruning (CCP) để giảm overfitting.
2.4 CHAID (Chi-squared Automatic Interaction Detector)
- Tiêu chí: Kiểm định chi-squared cho các biến danh mục, F-test cho biến số.
- Đặc điểm: Cho phép nhiều hơn 2 nhánh tại mỗi nút.
3. Các Bước Cơ Bản Để Vẽ Cây Quyết Định
Bước 1: Thu Thập và Chuẩn Bị Dữ Liệu
- Thu thập dữ liệu: Đảm bảo dữ liệu đại diện cho vấn đề.
- Xử lý missing values: Loại bỏ, thay thế bằng mean/median hoặc dùng thuật toán đặc biệt.
- Mã hoá biến danh mục: Sử dụng One-Hot Encoding hoặc Label Encoding (đối với các thuật toán như CART không cần).
- Chia tập dữ liệu: Train (70-80%), Test (20-30%).
Bước 2: Lựa Chọn Thuật Toán
- Phân loại: ID3, C4.5, CART, CHAID.
- Hồi quy: CART (Regression Tree).
Bước 3: Xây Dựng Cây
- Tính chỉ số chia (splitting criterion) cho mỗi thuộc tính.
- Chọn thuộc tính tốt nhất (có chỉ số cao nhất) để tạo nút gốc.
- Tách dữ liệu thành các nhánh dựa trên giá trị thuộc tính.
- Lặp lại quá trình cho mỗi nhánh cho đến khi:
- Đạt độ sâu tối đa.
- Không còn cải thiện chỉ số.
- Số mẫu trong nút nhỏ hơn ngưỡng tối thiểu.
Bước 4: Cắt Tỉa (Pruning)

Có thể bạn quan tâm: Cách Vẽ Cá Sấu 3d: Bước Đột Phá Trong Nghệ Thuật Minh Họa
- Pre-pruning: Dừng sớm khi đạt các tiêu chí (độ sâu, số mẫu tối thiểu).
- Post-pruning: Xây dựng cây đầy đủ rồi cắt tỉa bằng cross-validation hoặc cost-complexity.
Bước 5: Đánh Giá Mô Hình
- Đối với phân loại: Accuracy, Precision, Recall, F1-score, ROC-AUC.
- Đối với hồi quy: RMSE, MAE, R².
Bước 6: Triển Khai và Giải Thích
- Triển khai: Export mô hình (pickle, joblib) hoặc chuyển thành mã rule.
- Giải thích: Dễ dàng trích xuất các rule dạng “Nếu … thì …”.
4. Thực Hành: Vẽ Cây Quyết Định Bằng Python
Dưới đây là một ví dụ chi tiết sử dụng thư viện scikit-learn để vẽ cây quyết định cho bộ dữ liệu Iris.
# Bước 1: Import thư viện
import pandas as pd
import numpy as np
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.metrics import accuracy_score, classification_report
import matplotlib.pyplot as plt # Bước 2: Load dữ liệu
iris = load_iris()
X = pd.DataFrame(iris.data, columns=iris.feature_names)
y = pd.Series(iris.target, name='target') # Bước 3: Chia tập train và test
X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y) # Bước 4: Khởi tạo và huấn luyện cây (CART)
clf = DecisionTreeClassifier( criterion='gini', # hoặc 'entropy' cho Information Gain max_depth=3, # giới hạn độ sâu để tránh overfitting min_samples_leaf=5, # số mẫu tối thiểu ở lá random_state=42
)
clf.fit(X_train, y_train) # Bước 5: Dự đoán và đánh giá
y_pred = clf.predict(X_test)
print('Accuracy:', accuracy_score(y_test, y_pred))
print(classification_report(y_test, y_pred, target_names=iris.target_names)) # Bước 6: Vẽ cây
plt.figure(figsize=(12,8))
plot_tree(clf, feature_names=iris.feature_names, class_names=iris.target_names, filled=True, rounded=True, impurity=False, proportion=True)
plt.title('Cây Quyết Định - Iris Dataset')
plt.show()
Giải Thích Kết Quả

Có thể bạn quan tâm: Cách Vẽ Cá Chép Tattoo Đẹp Và Ấn Tượng: Hướng Dẫn Từng Bước Cho Người Mới Bắt Đầu
- Accuracy thường trên 0.9 cho bộ dữ liệu Iris khi giới hạn độ sâu hợp lý.
- Cây vẽ hiển thị các điều kiện như
petal width (cm) <= 0.8… giúp người dùng hiểu rõ quy tắc phân loại.
5. Kỹ Thuật Nâng Cao Để Tối Ưu Cây Quyết Định
5.1 Grid Search & Cross-Validation
Sử dụng GridSearchCV để tìm siêu tham số tối ưu (max_depth, min_samples_split, min_samples_leaf, criterion).
from sklearn.model_selection import GridSearchCV param_grid = { 'max_depth': 2,3,4,5,6, 'min_samples_leaf': 1,2,4,6, 'criterion': 'gini', 'entropy'
}
grid = GridSearchCV(DecisionTreeClassifier(random_state=42), param_grid, cv=5, scoring='accuracy')
grid.fit(X_train, y_train)
print('Best params:', grid.best_params_)
print('Best CV score:', grid.best_score_)
5.2 Cost-Complexity Pruning (CCP)
path = clf.cost_complexity_pruning_path(X_train, y_train)
ccp_alphas, impurities = path.ccp_alphas, path.impurities # Lựa chọn alpha tối ưu qua cross-validation
best_alpha = ccp_alphasnp.argmin(impurities) # ví dụ đơn giản
pruned_clf = DecisionTreeClassifier(random_state=42, ccp_alpha=best_alpha)
pruned_clf.fit(X_train, y_train)
5.3 Feature Importance
importances = clf.feature_importances_
for name, imp in zip(iris.feature_names, importances): print(f'{name}: {imp:.4f}')
5.4 Ensemble: Random Forest & Gradient Boosting

- Random Forest: Tạo nhiều cây quyết định trên các bootstrap sample, giảm variance.
- Gradient Boosting: Xây dựng cây tuần tự, mỗi cây học lỗi của cây trước, giảm bias.
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X_train, y_train) gb = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, random_state=42)
gb.fit(X_train, y_train)
6. Ứng Dụng Thực Tế Của Cây Quyết Định
| Ngành | Vấn đề | Cách dùng cây quyết định |
|---|---|---|
| Tài chính | Rủi ro vay vốn | Dự đoán khả năng vỡ nợ dựa trên thu nhập, lịch sử tín dụng. |
| Y tế | Chẩn đoán bệnh | Phân loại bệnh nhân thành nhóm nguy cơ cao/thấp dựa trên các chỉ số sinh học. |
| Marketing | Phân khúc khách hàng | Xác định nhóm khách hàng tiềm năng cho chiến dịch quảng cáo. |
| Sản xuất | Dự đoán lỗi máy | Dự báo lỗi thiết bị dựa trên nhiệt độ, áp suất, thời gian vận hành. |
| Giáo dục | Dự đoán thành tích | Dự đoán khả năng tốt nghiệp dựa trên điểm trung bình, giờ học, tham gia hoạt động. |
7. Những Sai Lầm Thường Gặp Khi Vẽ Cây Quyết Định
- Không cắt tỉa: Để cây quá sâu dẫn tới overfitting.
- Chọn sai tiêu chí chia: Ví dụ dùng Gini cho dữ liệu mất cân bằng nghiêm trọng.
- Bỏ qua việc cân bằng lớp: Khi có lớp không cân bằng, cần dùng kỹ thuật oversampling/undersampling hoặc thay đổi metric.
- Không chuẩn hoá dữ liệu: Mặc dù cây không yêu cầu, nhưng khi kết hợp với các mô hình ensemble có thể ảnh hưởng.
- Quá phụ thuộc vào một feature: Kiểm tra multicollinearity, loại bỏ các feature lặp lại.
8. Kết Luận
Cây quyết định là một công cụ mạnh mẽ, vừa dễ hiểu vừa linh hoạt, phù hợp cho cả người mới bắt đầu lẫn các chuyên gia dữ liệu. Việc vẽ cây quyết định không chỉ dừng lại ở việc áp dụng thuật toán, mà còn đòi hỏi:
- Hiểu rõ dữ liệu và tiền xử lý hợp lý.
- Lựa chọn tiêu chí và siêu tham số phù hợp.
- Áp dụng cắt tỉa để tránh overfitting.
- Đánh giá và giải thích mô hình một cách khách quan.
Bằng cách nắm vững các bước và kỹ thuật nêu trên, bạn sẽ tự tin xây dựng các cây quyết định chất lượng, hỗ trợ đưa ra những quyết định kinh doanh và nghiên cứu thông minh hơn. Hãy bắt đầu thực hành ngay hôm nay, khám phá sức mạnh của cây quyết định trong dự án của bạn!