
TÓM TẮT
- 1 1. Giới thiệu chung về SEM và tầm quan trọng của việc vẽ mô hình
- 2 2. Chọn phần mềm vẽ mô hình SEM phù hợp
- 3 3. Xây dựng khung lý thuyết và xác định các biến
- 4 4. Thiết kế sơ đồ mô hình (Path Diagram)
- 5 5. Kiểm tra độ tin cậy và tính hợp lệ của mô hình
- 6 6. Điều chỉnh và tối ưu mô hình
- 7 7. Báo cáo kết quả và trình bày mô hình SEM
- 8 8. Những lỗi thường gặp khi vẽ mô hình SEM và cách tránh
- 9 9. Tổng kết
1. Giới thiệu chung về SEM và tầm quan trọng của việc vẽ mô hình
Structural Equation Modeling (SEM) – hay còn gọi là mô hình phương trình cấu trúc – là một trong những phương pháp thống kê mạnh mẽ nhất hiện nay, cho phép nhà nghiên cứu kiểm định các mối quan hệ phức tạp giữa các biến tiềm ẩn (latent variables) và biến quan sát (observed variables). Với khả năng kết hợp phân tích yếu tố (factor analysis) và mô hình hồi quy (regression), SEM trở thành công cụ không thể thiếu trong nhiều lĩnh vực như tâm lý học, giáo dục, y tế, kinh tế, xã hội học và quản trị kinh doanh.
Tuy nhiên, để khai thác hết tiềm năng của SEM, việc vẽ mô hình một cách chuẩn xác, logic và dễ hiểu là bước đầu tiên và cực kỳ quan trọng. Một mô hình được vẽ tốt không chỉ giúp người đọc nhanh chóng nắm bắt cấu trúc nghiên cứu, mà còn giảm thiểu sai sót trong quá trình nhập dữ liệu và phân tích. Ngược lại, mô hình lộn xộn, thiếu logic sẽ gây khó khăn trong việc giải thích, thậm chí làm sai lệch kết quả.
Bài viết này sẽ cung cấp cho bạn một hướng dẫn chi tiết, từng bước một, từ việc lựa chọn phần mềm, chuẩn bị dữ liệu, xác định các biến, xây dựng cấu trúc mô hình, cho tới cách vẽ và kiểm tra mô hình SEM một cách chuyên nghiệp. Nội dung được chia thành các phần chính:
- Chuẩn bị và lựa chọn công cụ: Các phần mềm phổ biến (AMOS, LISREL, Mplus, R (lavaan), Stata, SmartPLS) và tiêu chí lựa chọn.
- Xây dựng khung lý thuyết và xác định biến: Phân loại biến tiềm ẩn, biến quan sát, cách viết giả thuyết.
- Thiết kế sơ đồ mô hình (Path Diagram): Quy tắc vẽ, ký hiệu, cách bố trí các khối và mũi tên.
- Nhập dữ liệu và kiểm tra mô hình: Kiểm tra độ tin cậy, tính hợp lệ, các chỉ số phù hợp (CFI, TLI, RMSEA, SRMR…).
- Điều chỉnh và tối ưu mô hình: Sửa đổi, loại bỏ hoặc thêm các quan hệ dựa trên kết quả.
- Báo cáo và trình bày mô hình: Cách viết phần mô tả mô hình trong báo cáo, cách chèn hình vẽ vào tài liệu.
Mục tiêu cuối cùng là giúp bạn không chỉ vẽ được một mô hình SEM chuẩn, mà còn hiểu sâu về lý thuyết đằng sau mỗi yếu tố, từ đó nâng cao chất lượng nghiên cứu và khả năng truyền tải kết quả.
2. Chọn phần mềm vẽ mô hình SEM phù hợp
2.1. Các phần mềm phổ biến

Có thể bạn quan tâm: Cách Vẽ Mô Hình Mvc: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Thực Tiễn
| Phần mềm | Ngôn ngữ | Đặc điểm nổi bật | Độ khó sử dụng | Giá thành |
|---|---|---|---|---|
| AMOS | GUI (đồ họa) | Dễ vẽ, tích hợp SPSS, tự động tính toán | Trung bình | Có bản dùng thử, phí bản quyền |
| LISREL | Lệnh | Độ chính xác cao, được sử dụng trong các tạp chí uy tín | Cao | Phí bản quyền |
| Mplus | Lệnh | Hỗ trợ mô hình phức tạp (mixture, multilevel), mạnh trong phân tích dữ liệu thiếu | Cao | Phí bản quyền |
| R (lavaan) | R | Miễn phí, mở rộng, cộng đồng lớn, hỗ trợ đa dạng | Trung bình‑cao | Miễn phí |
| Stata | Lệnh | Tích hợp SEM trong môi trường đa dạng | Trung bình | Phí bản quyền |
| SmartPLS | GUI | Thích hợp cho PLS‑SEM, không yêu cầu phân phối chuẩn | Dễ | Có bản miễn phí (có giới hạn) |
2.2. Tiêu chí lựa chọn
- Mục tiêu nghiên cứu: Nếu bạn cần mô hình tuyến tính đơn giản, AMOS hoặc SmartPLS là lựa chọn nhanh. Đối với mô hình phức tạp (latent growth, mixture), Mplus hoặc lavaan (R) sẽ phù hợp hơn.
- Kỹ năng lập trình: Người không quen lập trình nên ưu tiên phần mềm có giao diện đồ họa (AMOS, SmartPLS). Người có kiến thức R hoặc Python có thể tận dụng lavaan.
- Ngân sách: Nếu ngân sách hạn chế, R (lavaan) và SmartPLS (phiên bản miễn phí) là giải pháp tối ưu.
- Hỗ trợ và cộng đồng: R và Mplus có cộng đồng người dùng mạnh, dễ tìm tài liệu, ví dụ thực tế.
Khuyến nghị: Đối với người mới bắt đầu và muốn nhanh chóng có kết quả, AMOS (kèm SPSS) hoặc SmartPLS là lựa chọn tốt nhất. Khi đã nắm vững lý thuyết và muốn mở rộng, chuyển sang R (lavaan) để tận dụng tính linh hoạt.
3. Xây dựng khung lý thuyết và xác định các biến
3.1. Phân loại biến trong SEM
| Loại biến | Định nghĩa | Ví dụ |
|---|---|---|
| Biến tiềm ẩn (latent variable) | Không thể đo trực tiếp, được ước lượng từ các biến quan sát | Thái độ khách hàng, năng lực lãnh đạo, sức khỏe tâm thần |
| Biến quan sát (observed / manifest variable) | Được đo trực tiếp, thường là các câu hỏi, chỉ số | Điểm trả lời trên thang Likert, chỉ số doanh thu, mức độ hài lòng |
| Biến độc lập (exogenous) | Không chịu ảnh hưởng từ các biến trong mô hình | Nhân khẩu học, môi trường làm việc |
| Biến phụ thuộc (endogenous) | Bị giải thích bởi một hoặc nhiều biến trong mô hình | Hành vi mua hàng, hiệu suất công việc |
3.2. Viết giả thuyết nghiên cứu
Giả thuyết trong SEM thường được viết dưới dạng quan hệ đường dẫn (path). Ví dụ:
- H1: Thái độ tích cực (latent) có ảnh hưởng tích cực đến ý định mua hàng (latent).
- H2: Niềm tin vào thương hiệu (latent) trung gian cho mối quan hệ giữa Thái độ và Ý định mua hàng.
- H3: Độ tuổi (exogenous) ảnh hưởng gián tiếp đến Ý định mua hàng thông qua Thái độ.
Khi viết giả thuyết, cần:
- Rõ ràng: Đặt tên biến nhất quán, tránh nhầm lẫn.
- Có cơ sở lý thuyết: Dựa trên các nghiên cứu trước, lý thuyết nền tảng.
- Có tính khả thi: Đảm bảo dữ liệu thu thập được có thể đo lường các biến.
3.3. Xây dựng bảng đo (questionnaire)

Có thể bạn quan tâm: Cách Vẽ Mô Hình Lớp Trong Phân Tích Và Thiết Kế Hệ Thống: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
- Số lượng mục: Mỗi latent variable thường cần ít nhất 3-4 mục để đảm bảo độ tin cậy.
- Định dạng: Thang Likert 5‑ hoặc 7‑điểm là phổ biến.
- Kiểm tra nội dung: Nhờ chuyên gia đánh giá để đảm bảo tính hợp lệ nội dung.
4. Thiết kế sơ đồ mô hình (Path Diagram)
4.1. Quy tắc vẽ chuẩn
| Thành phần | Ký hiệu | Mô tả |
|---|---|---|
| Biến tiềm ẩn | Hình elip (ellipse) | Đặt tên biến ở trung tâm |
| Biến quan sát | Hình chữ nhật (rectangle) | Kết nối với biến tiềm ẩn bằng mũi tên một chiều |
| Đường dẫn (path) | Mũi tên một chiều → | Quan hệ nguyên nhân‑kết quả |
| Hệ số tương quan | Đường thẳng hai chiều ↔ | Quan hệ không có hướng (đối với biến exogenous) |
| Độ mạnh | Độ dày mũi tên | Thể hiện hệ số chuẩn (standardized) lớn hơn 0.1 thường được vẽ dày hơn |
| Lỗi đo (error) | Đường mũi tên từ “e” (error) đến biến quan sát | Thể hiện phần biến không giải thích được bởi latent variable |
4.2. Các bước vẽ mô hình trong AMOS (ví dụ)
- Mở AMOS → File > New → Chọn “Draw” để chuyển sang chế độ vẽ.
- Thêm latent variables: Chọn công cụ “Ellipse” → Click vào canvas → Đặt tên (VD: “Attitude”).
- Thêm observed variables: Chọn công cụ “Rectangle” → Vẽ các mục đo (VD: “Q1”, “Q2”, “Q3”).
- Kết nối: Dùng “Draw single-headed arrow” để nối latent → observed; dùng “Draw double-headed arrow” để nối các latent exogenous.
- Thêm lỗi đo: Chọn “Add error term” → Click vào mỗi observed variable → Sẽ tự động tạo “e1”, “e2”,…
- Đặt tên cho các mũi tên: Click vào mũi tên → trong “Properties” nhập “Label” là hệ số (có thể để trống, AMOS sẽ tự tính).
- Lưu mô hình: File > Save As → Đặt tên và lưu dưới định dạng .amf.
4.3. Tips bố trí mô hình đẹp, dễ đọc
- Sắp xếp theo chiều dọc: Đặt các latent exogenous ở trên, endogenous ở dưới.
- Giữ khoảng cách đều: Tránh các mũi tên chồng chéo; sử dụng “Align” và “Distribute” trong AMOS.
- Sử dụng màu sắc: Đánh dấu nhóm biến (ví dụ: màu xanh cho biến độc lập, màu đỏ cho biến phụ thuộc) để tăng tính trực quan.
- Ghi chú: Thêm textbox để giải thích các ký hiệu, các chỉ số quan trọng (CFI, RMSEA) ngay trên sơ đồ.
4.4. Vẽ mô hình trong R (lavaan + semPlot)
# Cài đặt gói
install.packages(c("lavaan","semPlot"))
library(lavaan)
library(semPlot) # Định nghĩa mô hình
model <- ' # latent variables Attitude =~ Q1 + Q2 + Q3 Intention =~ I1 + I2 + I3 # structural paths Intention ~ Attitude + Trust Trust =~ T1 + T2 + T3
' # Fit model
fit <- sem(model, data = mydata) # Vẽ mô hình
semPaths(fit, what = "std", # hiển thị hệ số chuẩn layout = "tree2", # bố trí dạng cây edge.label.cex = 0.8, # kích thước nhãn residuals = FALSE, # không vẽ lỗi đo title = FALSE, nCharNodes = 0) # không cắt ngắn tên node
Kết quả sẽ cho ra một sơ đồ đẹp, có thể xuất ra file PNG, PDF bằng hàm png() hoặc pdf().
5. Kiểm tra độ tin cậy và tính hợp lệ của mô hình
Có thể bạn quan tâm: Cách Vẽ Mô Hình Harmonic: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
5.1. Độ tin cậy (Reliability)
- Cronbach’s Alpha: Đánh giá độ đồng nhất nội bộ; giá trị > 0.70 được chấp nhận.
- Composite Reliability (CR): Ưu tiên hơn Cronbach vì tính đến trọng số; CR > 0.70 là tiêu chuẩn.
- Omega (ω): Cũng là một chỉ số tin cậy, đặc biệt khi các mục không đồng nhất.
5.2. Tính hợp lệ (Validity)
| Loại hợp lệ | Kiểm tra | Tiêu chuẩn |
|---|---|---|
| Convergent validity | AVE (Average Variance Extracted) | AVE ≥ 0.50 |
| Discriminant validity | Fornell‑Larcker criterion, HTMT | AVE_i > max( squared correlations ), HTMT < 0.85 |
| Nomological validity | Kiểm tra mô hình toàn cục, phù hợp với lý thuyết | Các đường dẫn có ý nghĩa thống kê và phù hợp lý thuyết |
5.3. Chỉ số phù hợp mô hình (Fit Indices)
| Chỉ số | Công thức/Ý nghĩa | Ngưỡng chấp nhận |
|---|---|---|
| χ² (Chi-square) | Kiểm định tổng thể, phụ thuộc mẫu | p > 0.05 (khó đạt khi n lớn) |
| χ²/df | Tỷ lệ chi-square / df | < 3 (tốt), < 5 (chấp nhận) |
| CFI (Comparative Fit Index) | So sánh với mô hình độc lập | ≥ 0.95 (tốt), ≥ 0.90 (đủ) |
| TLI (Tucker‑Lewis Index) | Tương tự CFI | ≥ 0.95 (tốt), ≥ 0.90 (đủ) |
| RMSEA (Root Mean Square Error of Approximation) | Sai số trung bình | ≤ 0.06 (tốt), ≤ 0.08 (đủ) |
| SRMR (Standardized Root Mean Square Residual) | Sai số chuẩn hoá | ≤ 0.08 (đủ) |
Khi một mô hình không đạt các ngưỡng này, chúng ta cần điều chỉnh mô hình (thêm/loại bỏ đường dẫn, kiểm tra outliers, cân nhắc mô hình đa cấp).
6. Điều chỉnh và tối ưu mô hình
6.1. Phân tích các chỉ số Modification Index (MI)

Có thể bạn quan tâm: Cách Vẽ Mô Hình Business: Hướng Dẫn Chi Tiết Từ A Đến Z
- MI cho biết khi thêm một đường dẫn mới, chi‑square sẽ giảm bao nhiêu. Giá trị MI > 10 thường được xem xét.
- Tuy nhiên, không nên chỉ dựa vào MI mà không có cơ sở lý thuyết. Mỗi thay đổi cần được giải thích hợp lý.
6.2. Loại bỏ biến hoặc đường dẫn không cần thiết
- Hệ số không có ý nghĩa (p > 0.05) và giá trị chuẩn nhỏ (< 0.10) thường được loại bỏ để đơn giản hoá mô hình.
- Kiểm tra lại các chỉ số fit sau mỗi lần điều chỉnh để tránh over‑fitting.
6.3. Kiểm tra đa cộng (multicollinearity)
- VIF (Variance Inflation Factor) > 5 hoặc 10 cho thấy đa cộng, có thể gây sai lệch hệ số.
- Giải pháp: Kết hợp các biến tương tự, hoặc sử dụng Partial Least Squares SEM (PLS‑SEM) nếu đa cộng quá cao.
6.4. Kiểm tra tính ổn định (Stability)
- Bootstrap: Thực hiện 2000‑5000 mẫu bootstrap để kiểm tra độ tin cậy của các hệ số.
- Cross‑validation: Chia dữ liệu thành training và validation để kiểm tra tính tổng quát.
7. Báo cáo kết quả và trình bày mô hình SEM
7.1. Cấu trúc phần báo cáo
- Giới thiệu: Đặt vấn đề, mục tiêu nghiên cứu, lý thuyết nền tảng.
- Phương pháp: Mô tả mẫu, công cụ thu thập dữ liệu, phần mềm SEM sử dụng.
- Phân tích đo lường: Đánh giá độ tin cậy, hợp lệ (Cronbach, AVE, CR…).
- Kiểm tra mô hình: Trình bày các chỉ số fit, bảng hệ số đường dẫn (standardized, t‑value, p‑value).
- Điều chỉnh mô hình: Mô tả các bước điều chỉnh, lý do lựa chọn.
- Kết luận và thảo luận: Giải thích ý nghĩa các hệ số, so sánh với nghiên cứu trước, đề xuất thực tiễn.
- Hạn chế và hướng nghiên cứu tiếp theo.
7.2. Trình bày sơ đồ mô hình
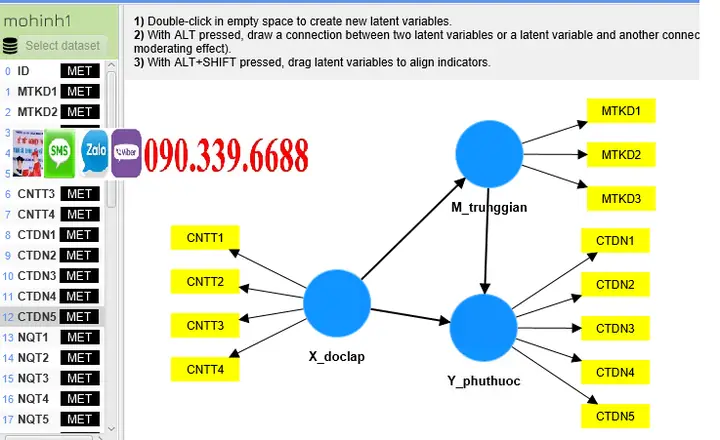
- Kích thước: Đảm bảo các ký hiệu và nhãn đọc được khi in hoặc trình chiếu.
- Màu sắc: Dùng màu để phân biệt nhóm biến, nhưng tránh quá nhiều màu gây rối mắt.
- Chú thích: Thêm bảng giải thích các ký hiệu (latent, observed, error) và các chỉ số fit.
- Định dạng file: PNG hoặc PDF chất lượng cao (≥300 DPI) để chèn vào Word, LaTeX.
7.3. Ví dụ minh họa (trích từ nghiên cứu mẫu)
Figure 1. Structural model of consumer purchase intention.
- Latent variables: Attitude (AT), Trust (TR), Purchase Intention (PI)
- Observed variables: AT1‑AT4, TR1‑TR3, PI1‑PI3
- Standardized path coefficients: AT → PI = 0.42 (p < .001), TR → PI = 0.31 (p = .002)
- Fit indices: χ²/df = 2.13, CFI = 0.96, TLI = 0.95, RMSEA = 0.045, SRMR = 0.032
8. Những lỗi thường gặp khi vẽ mô hình SEM và cách tránh
| Lỗi | Nguyên nhân | Cách khắc phục |
|---|---|---|
| Mô hình quá phức tạp | Thêm quá nhiều latent và đường dẫn không cần thiết | Bắt đầu với mô hình cơ bản, chỉ thêm khi có lý thuyết hỗ trợ |
| Không đạt độ tin cậy | Số mục đo quá ít, hoặc câu hỏi không đồng nhất | Tăng số mục (≥3), kiểm tra nội dung với chuyên gia |
| Độ hợp lệ kém | Các latent không tách biệt rõ ràng | Kiểm tra Fornell‑Larcker, thử loại bỏ hoặc gộp latent |
| Chi‑square quá lớn | Mẫu quá nhỏ hoặc mô hình không phù hợp | Tăng kích thước mẫu, hoặc đơn giản hoá mô hình |
| Đường dẫn ngược chiều | Khi vẽ mũi tên ngược lại với giả thuyết | Kiểm tra lại giả thuyết, sử dụng chỉ số đường dẫn để xác nhận |
| Không kiểm tra đa cộng | Các biến độc lập tương quan mạnh | Tính VIF, loại bỏ hoặc kết hợp biến |
9. Tổng kết
Việc vẽ mô hình SEM không chỉ là một công đoạn đồ họa mà còn là quá trình phản ánh sâu sắc lý thuyết, kiểm định dữ liệu và truyền tải kết quả một cách rõ ràng. Bằng cách tuân thủ các bước:
- Lựa chọn phần mềm phù hợp (AMOS, R‑lavaan, SmartPLS…).
- Xây dựng khung lý thuyết và xác định biến một cách có hệ thống.
- Vẽ sơ đồ mô hình theo quy tắc chuẩn, sử dụng ký hiệu và bố trí hợp lý.
- Kiểm tra độ tin cậy, hợp lệ và fit của mô hình, thực hiện điều chỉnh dựa trên lý thuyết và chỉ số thống kê.
- Báo cáo kết quả một cách chuyên nghiệp, kèm hình vẽ mô hình đẹp, dễ hiểu.
Bạn sẽ có một mô hình SEM vững chắc, đáp ứng yêu cầu của các tạp chí uy tín và cung cấp những insight giá trị cho thực tiễn. Hãy nhớ rằng, mô hình tốt bắt đầu từ việc vẽ đúng, và quá trình này là sự kết hợp giữa kiến thức thống kê, tư duy logic và kỹ năng trình bày.
Chúc bạn thành công trong hành trình nghiên cứu và tạo dựng các mô hình SEM chất lượng!