
TÓM TẮT
- 1 Mở Đầu: Tầm Quan Trọng Của Data Model Trong Phát Triển Ứng Dụng
- 2 1. Khái Niệm Cơ Bản Về Data Model
- 3 2. Quy Trình Vẽ Data Model Toàn Diện
- 4 3. Kỹ Thuật Chuẩn Hóa (Normalization) Chi Tiết
- 5 4. Các Công Cụ Vẽ Data Model Phổ Biến
- 6 5. Thực Hành: Vẽ Data Model Cho Ứng Dụng Thương Mại Điện Tử
- 7 6. Những Sai Lầm Thường Gặp Khi Vẽ Data Model
- 8 7. Một Số Mẫu Data Model Thông Dụng
- 9 8. Thực Hành Tự Động Hóa: Từ ER Diagram Đến SQL
- 10 9. Kiểm Tra và Đánh Giá Data Model
- 11 10. Những Xu Hướng Mới Trong Data Modeling
- 12 11. Kết Luận: Xây Dựng Data Model Thành Công Như Thế Nào?
Mở Đầu: Tầm Quan Trọng Của Data Model Trong Phát Triển Ứng Dụng
Trong thời đại số hoá ngày nay, dữ liệu đã trở thành tài sản quan trọng nhất của mọi doanh nghiệp. Tuy nhiên, để khai thác giá trị từ dữ liệu, chúng ta cần một cấu trúc logic và rõ ràng để tổ chức, lưu trữ và truy xuất thông tin. Đó chính là data model (mô hình dữ liệu). Việc vẽ data model không chỉ giúp các nhà phát triển, kiến trúc sư hệ thống hiểu rõ mối quan hệ giữa các thực thể mà còn giảm thiểu rủi ro lỗi thiết kế, tối ưu hiệu suất và nâng cao khả năng bảo trì hệ thống.
Bài viết này sẽ cung cấp một hướng dẫn chi tiết, từ những kiến thức cơ bản nhất đến các kỹ thuật nâng cao, giúp bạn tự tin vẽ data model cho bất kỳ dự án nào, dù là một ứng dụng web đơn giản hay một hệ thống doanh nghiệp phức tạp.
1. Khái Niệm Cơ Bản Về Data Model
1.1. Data Model là gì?
Data model là bộ khung mô tả cách dữ liệu được tổ chức, lưu trữ và tương tác trong một hệ thống. Nó bao gồm:
- Thực thể (Entity): Các đối tượng thực tế hoặc khái niệm trong lĩnh vực nghiệp vụ (ví dụ: Khách hàng, Sản phẩm, Đơn hàng).
- Thuộc tính (Attribute): Các đặc điểm, thông tin chi tiết của thực thể (ví dụ: Tên khách hàng, Giá sản phẩm, Ngày đặt hàng).
- Mối quan hệ (Relationship): Cách các thực thể liên kết với nhau (ví dụ: Khách hàng đặt Đơn hàng, Đơn hàng chứa Sản phẩm).
1.2. Các Loại Data Model Phổ Biến
| Loại Model | Đặc điểm | Khi nào dùng |
|---|---|---|
| Conceptual Data Model (Mô hình khái niệm) | Tập trung vào khái niệm nghiệp vụ, không quan tâm tới chi tiết kỹ thuật. | Giai đoạn thu thập yêu cầu, thảo luận với stakeholders. |
| Logical Data Model (Mô hình logic) | Chi tiết hơn, mô tả các thực thể, thuộc tính, quan hệ, kiểu dữ liệu, khóa chính/phụ. | Khi thiết kế chi tiết, chuẩn bị cho việc triển khai DBMS. |
| Physical Data Model (Mô hình vật lý) | Thực thi trên hệ quản trị cơ sở dữ liệu cụ thể, bao gồm chỉ mục, partition, storage. | Khi triển khai, tối ưu hiệu năng và quản lý tài nguyên. |
2. Quy Trình Vẽ Data Model Toàn Diện

Có thể bạn quan tâm: Cách Vẽ Data Flow: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
2.1. Bước 1: Thu Thập Yêu Cầu và Phân Tích Nghiệp Vụ
- Phỏng vấn stakeholders: Hiểu mục tiêu kinh doanh, quy trình làm việc.
- Xác định các thực thể chính: Liệt kê các đối tượng quan trọng trong nghiệp vụ.
- Thu thập thuộc tính: Đối với mỗi thực thể, ghi lại các thông tin cần lưu trữ.
- Xác định quan hệ: Làm rõ cách các thực thể tương tác với nhau (một‑một, một‑nhiều, nhiều‑nhiều).
2.2. Bước 2: Vẽ Conceptual Data Model
- Sử dụng công cụ: Draw.io, Lucidchart, Microsoft Visio, hoặc các phần mềm ERD chuyên dụng (MySQL Workbench, ER/Studio, PowerDesigner).
- Ký hiệu: Thực thể thường được biểu diễn bằng hình chữ nhật, quan hệ bằng hình thoi, thuộc tính có thể ghi bên trong hoặc dưới thực thể.
- Mục tiêu: Đảm bảo mọi người đều hiểu mô hình mà không cần kiến thức kỹ thuật sâu.
2.3. Bước 3: Chuyển Sang Logical Data Model
- Xác định khóa chính (Primary Key – PK) cho mỗi thực thể.
- Xác định khóa ngoại (Foreign Key – FK) để thể hiện quan hệ.
- Định dạng kiểu dữ liệu (VARCHAR, INT, DATE, …) cho từng thuộc tính.
- Chuẩn hoá (Normalization): Áp dụng các chuẩn 1NF, 2NF, 3NF để loại bỏ dư thừa dữ liệu.
- Kiểm tra tính toàn vẹn: Ràng buộc NOT NULL, UNIQUE, CHECK.
2.4. Bước 4: Thiết Kế Physical Data Model
- Lựa chọn DBMS: MySQL, PostgreSQL, Oracle, SQL Server, MongoDB (đối với NoSQL).
- Tối ưu chỉ mục: Tạo index cho các cột thường xuyên dùng trong WHERE, JOIN, ORDER BY.
- Partition & Sharding: Nếu dữ liệu lớn, cân nhắc phân vùng hoặc chia dữ liệu.
- Quy hoạch lưu trữ: Định nghĩa tablespace, filegroup, tablespaces cho Oracle, PostgreSQL.
- Cấu hình bảo mật: Quyền truy cập, mã hoá dữ liệu.
2.5. Bước 5: Kiểm Thử và Rà Soát
- Kiểm tra tính toàn vẹn: Thực hiện các test case để chắc chắn ràng buộc hoạt động đúng.
- Performance testing: Chạy query mẫu, đo thời gian, tối ưu lại chỉ mục nếu cần.
- Review với team: Nhận phản hồi và chỉnh sửa.
3. Kỹ Thuật Chuẩn Hóa (Normalization) Chi Tiết
3.1. Định Nghĩa Các Chuẩn
Có thể bạn quan tâm: Cách Vẽ Dao Tiện: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
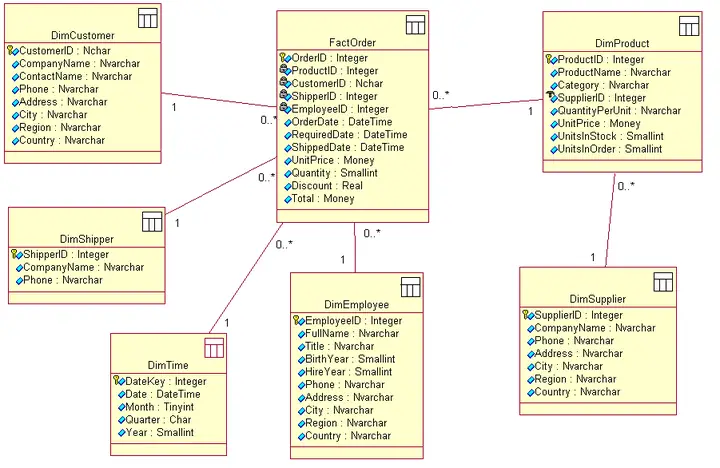
- 1NF (First Normal Form): Mỗi cột chỉ chứa giá trị nguyên tử, không có tập hợp lặp.
- 2NF (Second Normal Form): Đạt 1NF và mọi thuộc tính không khóa phải phụ thuộc toàn phần vào khóa chính.
- 3NF (Third Normal Form): Đạt 2NF và không có phụ thuộc bắc cầu (non‑key attribute phụ thuộc vào một non‑key attribute).
3.2. Ví Dụ Thực Tế
Giả sử có bảng OrderDetail:
| OrderID | ProductID | ProductName | Quantity | UnitPrice |
|---|---|---|---|---|
- Vấn đề:
ProductNamevàUnitPricephụ thuộc vàoProductID, không phải toàn bộ khóa (OrderID,ProductID). - Giải pháp: Tách ra thành hai bảng:
OrderDetail (OrderID, ProductID, Quantity)Product (ProductID, ProductName, UnitPrice)
Sau khi chuẩn hoá, dữ liệu trùng lặp giảm, cập nhật giá sản phẩm chỉ thực hiện một lần.
3.3. Khi Nào Không Cần Chuẩn Hóa Đến 3NF?
Trong một số trường hợp, denormalization (giảm chuẩn hoá) có thể tăng hiệu năng truy vấn, ví dụ:
- Báo cáo: Khi cần một bảng tổng hợp thường xuyên, lưu trữ dữ liệu dự trữ.
- Hệ thống OLAP: Dữ liệu được tối ưu cho truy vấn phức tạp, không cần chuẩn hoá đầy đủ.
4. Các Công Cụ Vẽ Data Model Phổ Biến
| Công Cụ | Loại DBMS Hỗ Trợ | Đặc Điểm Nổi Bật | Giá |
|---|---|---|---|
| MySQL Workbench | MySQL, MariaDB | Tự động tạo SQL từ ER diagram, reverse engineering | Miễn phí |
| pgModeler | PostgreSQL | Hỗ trợ thiết kế physical model, generate DDL | $99 |
| Microsoft Visio | Tất cả (qua ODBC) | Giao diện kéo‑thả mạnh mẽ, tích hợp Office | Thuê bao Office 365 |
| Lucidchart | Đám mây, hỗ trợ nhiều DBMS | Làm việc nhóm thời gian thực, template đa dạng | Gói miễn phí/ trả phí |
| ER/Studio | Oracle, SQL Server, MySQL, PostgreSQL | Quản lý metadata, version control | Cao cấp (doanh nghiệp) |
| DbSchema | Hỗ trợ đa DBMS, NoSQL | Visual query builder, schema sync | $149 |
4.1. Lựa Chọn Công Cụ Phù Hợp
- Dự án nhỏ, cá nhân: MySQL Workbench, Draw.io, Lucidchart (gói miễn phí).
- Dự án doanh nghiệp, đa DBMS: ER/Studio, Enterprise Architect, PowerDesigner.
- NoSQL: DbSchema (hỗ trợ MongoDB), Hackolade (cho JSON, GraphQL).
5. Thực Hành: Vẽ Data Model Cho Ứng Dụng Thương Mại Điện Tử
5.1. Thu Thập Yêu Cầu
- Thực thể chính: User, Product, Category, Order, OrderItem, Payment, Review.
- Quan hệ:
- User đặt Order (1‑N).
- Order có OrderItem (1‑N).
- OrderItem liên kết Product (N‑1).
- Product thuộc Category (N‑1).
- User viết Review cho Product (N‑N).
- Order có Payment (1‑1).
5.2. Conceptual Model (ER Diagram)

Có thể bạn quan tâm: Cách Vẽ Dáng Người: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
User---<places>---Order---<contains>---OrderItem---<refers to>---Product---<belongs to>---Category | | |---<writes>---Review---<about>---| | |---<makes>---Payment
5.3. Logical Model (Chi Tiết)
| Table | Primary Key | Foreign Keys | Thuộc tính |
|---|---|---|---|
| User | user_id | – | username, email, password_hash, created_at, status |
| Category | category_id | – | name, description, parent_category_id (FK to Category) |
| Product | product_id | category_id | name, description, price, stock_quantity, created_at |
| Order | order_id | user_id | order_date, status, total_amount |
| OrderItem | order_item_id | order_id, product_id | quantity, unit_price, discount |
| Payment | payment_id | order_id | payment_method, payment_date, amount, status |
| Review | review_id | user_id, product_id | rating, comment, created_at |
5.4. Physical Model (Tối Ưu)
- Indexes:
User(email)UNIQUE.Product(name)FULLTEXT (cho tìm kiếm).Order(order_date, status)composite index.OrderItem(product_id)để nhanh JOIN.- Partition:
Orderphân vùng theoorder_date(monthly) để giảm tải truy vấn lịch sử. - Triggers:
- Khi chèn OrderItem, tự động cập nhật
stock_quantitytrong Product. - Khi xóa Product, kiểm tra có Review tồn tại không; nếu có, chuyển sang trạng thái “archived”.
6. Những Sai Lầm Thường Gặp Khi Vẽ Data Model
- Quá tập trung vào kỹ thuật, bỏ qua nghiệp vụ: Thiết kế dựa trên DBMS mà không hiểu quy trình kinh doanh sẽ dẫn tới mô hình không phù hợp.
- Không chuẩn hoá: Dữ liệu trùng lặp gây lỗi cập nhật, tăng chi phí lưu trữ.
- Quá chuẩn hoá: Đưa ra quá nhiều bảng, gây phức tạp truy vấn, giảm hiệu năng.
- Bỏ qua chỉ mục: Truy vấn chậm, đặc biệt với bảng lớn.
- Không xét đến mở rộng: Thiết kế không linh hoạt cho các tính năng mới (ví dụ: thêm tính năng “wishlist” mà phải thay đổi cấu trúc dữ liệu lớn).
- Bỏ qua bảo mật: Không mã hoá dữ liệu nhạy cảm (password, thông tin thẻ) hoặc không phân quyền đúng cách.
7. Một Số Mẫu Data Model Thông Dụng
7.1. Mô Hình CRM (Customer Relationship Management)
- Entities: Customer, Contact, Lead, Opportunity, Activity, User.
- Relationships:
- Customer có Contact (1‑N).
- Lead chuyển thành Opportunity (1‑1).
- Opportunity được quản lý bởi User (N‑1).
- Activity liên quan tới Lead/Opportunity (N‑N).
7.2. Mô Hình Blog
- Entities: Author, Post, Category, Tag, Comment.
- Relationships:
- Author viết Post (1‑N).
- Post có Category (N‑1).
- Post có Tag (N‑N) → tạo bảng
PostTag. - Post có Comment (1‑N); Comment có thể trả lời Comment khác (self‑reference).
7.3. Mô Hình IoT (Internet of Things)
Có thể bạn quan tâm: Cách Vẽ Dan Trong: Hướng Dẫn Chi Tiết Từ Cơ Bản Đến Nâng Cao
- Entities: Device, Sensor, Measurement, Location, User.
- Relationships:
- Device có Sensor (1‑N).
- Sensor tạo Measurement (1‑N).
- Device được gán Location (N‑1).
- User quản lý Device (N‑N) → bảng
UserDevice.
8. Thực Hành Tự Động Hóa: Từ ER Diagram Đến SQL
Nhiều công cụ (MySQL Workbench, pgModeler) cho phép reverse engineering (từ DB hiện có tạo diagram) và forward engineering (từ diagram tạo DDL). Quy trình:
- Vẽ diagram trong công cụ.
- Xác định kiểu dữ liệu, ràng buộc, chỉ mục.
- Export ra file
.sql. - Chạy trên DBMS:
mysql -u root -p < schema.sql.
8.1. Ví Dụ Script SQL Từ Mô Hình Thương Mại Điện Tử
CREATE TABLE users ( user_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, username VARCHAR(50) NOT NULL, email VARCHAR(100) NOT NULL UNIQUE, password_hash CHAR(60) NOT NULL, created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP, status ENUM('active','inactive','banned') DEFAULT 'active'
); CREATE TABLE categories ( category_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, name VARCHAR(100) NOT NULL, description TEXT, parent_category_id BIGINT UNSIGNED, CONSTRAINT fk_category_parent FOREIGN KEY (parent_category_id) REFERENCES categories(category_id) ON DELETE SET NULL
); CREATE TABLE products ( product_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, category_id BIGINT UNSIGNED NOT NULL, name VARCHAR(200) NOT NULL, description TEXT, price DECIMAL(12,2) NOT NULL, stock_quantity INT UNSIGNED NOT NULL DEFAULT 0, created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP, CONSTRAINT fk_product_category FOREIGN KEY (category_id) REFERENCES categories(category_id) ON DELETE RESTRICT
); CREATE TABLE orders ( order_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, order_date TIMESTAMP DEFAULT CURRENT_TIMESTAMP, status ENUM('pending','paid','shipped','completed','canceled') DEFAULT 'pending', total_amount DECIMAL(12,2) NOT NULL, CONSTRAINT fk_order_user FOREIGN KEY (user_id) REFERENCES users(user_id) ON DELETE CASCADE
); CREATE TABLE order_items ( order_item_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, order_id BIGINT UNSIGNED NOT NULL, product_id BIGINT UNSIGNED NOT NULL, quantity INT UNSIGNED NOT NULL, unit_price DECIMAL(12,2) NOT NULL, discount DECIMAL(5,2) DEFAULT 0, CONSTRAINT fk_item_order FOREIGN KEY (order_id) REFERENCES orders(order_id) ON DELETE CASCADE, CONSTRAINT fk_item_product FOREIGN KEY (product_id) REFERENCES products(product_id) ON DELETE RESTRICT
); CREATE TABLE payments ( payment_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, order_id BIGINT UNSIGNED NOT NULL, payment_method ENUM('credit_card','paypal','bank_transfer') NOT NULL, payment_date TIMESTAMP DEFAULT CURRENT_TIMESTAMP, amount DECIMAL(12,2) NOT NULL, status ENUM('pending','completed','failed') DEFAULT 'pending', CONSTRAINT fk_payment_order FOREIGN KEY (order_id) REFERENCES orders(order_id) ON DELETE CASCADE
); CREATE TABLE reviews ( review_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, product_id BIGINT UNSIGNED NOT NULL, rating TINYINT UNSIGNED CHECK (rating BETWEEN 1 AND 5), comment TEXT, created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP, CONSTRAINT fk_review_user FOREIGN KEY (user_id) REFERENCES users(user_id) ON DELETE CASCADE, CONSTRAINT fk_review_product FOREIGN KEY (product_id) REFERENCES products(product_id) ON DELETE CASCADE
); -- Indexes
CREATE INDEX idx_product_name ON products(name);
CREATE INDEX idx_order_user_status ON orders(user_id, status);
CREATE INDEX idx_review_product_rating ON reviews(product_id, rating);
9. Kiểm Tra và Đánh Giá Data Model
9.1. Kiểm Tra Tính Toàn Vẹn
- Entity Integrity: Mỗi bảng có PK duy nhất, không NULL.
- Referential Integrity: FK trỏ đúng, hành vi ON DELETE/UPDATE được xác định.
- Domain Integrity: Kiểu dữ liệu, ràng buộc CHECK, ENUM.
9.2. Đánh Giá Hiệu Năng
- Explain Plan: Kiểm tra cost của các query thường dùng.
- Query Profiling: Sử dụng
SHOW PROFILE(MySQL) hoặcpg_stat_statements(PostgreSQL) để đo thời gian. - Load Test: Simulate hàng nghìn transaction/giây để xem bottleneck.
9.3. Đánh Giá Khả Năng Mở Rộng
- Thêm trường mới: Kiểm tra ảnh hưởng tới các trigger, view, stored procedure.
- Thêm thực thể mới: Xem mối quan hệ hiện có có cần thay đổi không.
- Migration: Sử dụng công cụ như Flyway, Liquibase để quản lý phiên bản schema.
10. Những Xu Hướng Mới Trong Data Modeling
10.1. Graph Data Model
- Sử dụng: Khi dữ liệu có mối quan hệ phức tạp, ví dụ mạng xã hội, recommendation engine.
- Công cụ: Neo4j, Amazon Neptune, Azure Cosmos DB (Graph API).
- Mô hình: Nodes (đỉnh) và Edges (cạnh), thuộc tính có thể gắn vào cả node và edge.
10.2. Document-Oriented Model (NoSQL)
- Công cụ: MongoDB, Couchbase, Firebase Firestore.
- Lợi ích: Linh hoạt schema, dễ lưu trữ dữ liệu lồng nhau (embedded documents), phù hợp với API JSON.
- Thách thức: Không có ràng buộc quan hệ mạnh mẽ, cần quản lý tính toàn vẹn ở tầng ứng dụng.
10.3. Data Vault
- Mô hình: Tập trung vào lưu trữ lịch sử, audit, và tích hợp dữ liệu từ nhiều nguồn.
- Thành phần: Hubs (định danh), Links (mối quan hệ), Satellites (thuộc tính lịch sử).
- Ứng dụng: Kho dữ liệu (Data Warehouse), Business Intelligence.
11. Kết Luận: Xây Dựng Data Model Thành Công Như Thế Nào?
- Hiểu rõ nghiệp vụ: Đừng để kỹ thuật chi phối quá sớm.
- Bắt đầu với mô hình khái niệm: Đảm bảo mọi stakeholder đều đồng ý.
- Áp dụng chuẩn hoá hợp lý: Đừng quá mức, cân nhắc trade‑off giữa chuẩn hoá và hiệu năng.
- Sử dụng công cụ hỗ trợ: Tự động hoá việc tạo DDL, kiểm tra ràng buộc.
- Kiểm thử toàn diện: Toàn vẹn, hiệu năng, bảo mật, mở rộng.
- Luôn cập nhật: Theo dõi xu hướng mới (Graph, NoSQL, Data Vault) để chọn giải pháp phù hợp.
Với quy trình và kiến thức chi tiết ở trên, bạn đã sẵn sàng vẽ data model cho bất kỳ dự án nào, từ những hệ thống đơn giản đến các kiến trúc doanh nghiệp phức tạp. Hãy bắt đầu bằng cách thu thập yêu cầu, tạo mô hình khái niệm, sau đó dần dần hoàn thiện thành logical và physical model, luôn kiểm tra và tối ưu hoá trong suốt vòng đời dự án. Khi data model được thiết kế chuẩn, bạn sẽ tiết kiệm được thời gian phát triển, giảm thiểu lỗi và tạo nền tảng vững chắc cho sự phát triển lâu dài của sản phẩm. Chúc bạn thành công!